通行证
积分 604
大米 颗
鳄梨 个
水井 尺
蓝莓 颗
萝卜 根
小米 粒
学分 个
注册时间 2016-6-30
最后登录 1970-1-1
2026(7-9月) -CS 博士 +5-10年 | 内推|其他地区 MachineLearningEng 其他 @google
注册一亩三分地论坛,查看更多干货!
您需要 登录 才可以下载或查看附件。没有帐号?注册账号
x
ML System Design 是 MLE 面试中最能拉开差距的一轮:算法和 ML 基础大家准备得都差不多,但系统设计轮直接考察你能不能把一个模糊的业务问题,拆解成一套可落地、可扩展、可迭代的完整系统。下面给出一个通用解题框架,以推荐系统为例一次讲透;换成搜索、广告、Feed 流,思路完全相通。 ..
. .и
一、澄清需求:先跟面试官对齐目标和约束.--
不要一上来就画架构。先问清三件事:.google и
1. 规模:DAU / QPS 量级、候选池大小(百万还是十亿)。
2. 延迟要求:线上 P99 延迟预算是多少(比如 100ms 以内),这直接决定后面能用多重的模型。
3. 业务场景:是信息流 Feed、电商搜索,还是广告?不同场景的优化目标完全不同——Feed 看时长和留存,广告看 eCPM,搜索看相关性。顺带确认优化目标是点击、转化还是长期留存。. check 1point3acres for more.
这一步做得好,面试官会觉得你有 owner 意识,而不是只会背八股文。
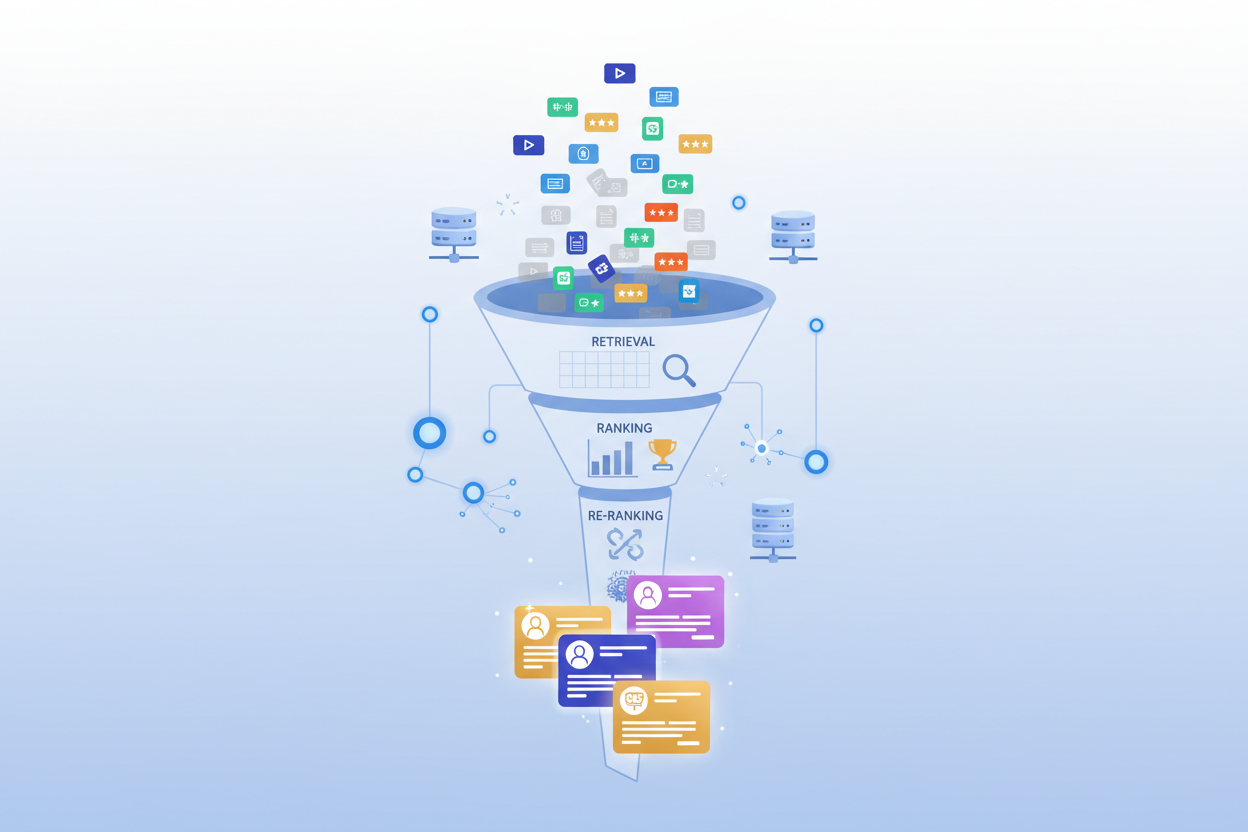
二、整体架构:召回→粗排→精排→重排. 1point3acres.com
经典四阶段漏斗,每一阶段都是“用更贵的模型、在更小的候选集上做更精细的打分”:
- 召回(Retrieval):从全量候选(千万到亿级)快速捞出几千个相关候选,要求高召回、低延迟,一般用双塔模型、协同过滤、向量检索。. 1point 3acres
- 粗排(Pre-ranking):轻量模型把几千砍到几百,平衡效果和性能。
. 1point3acres - 精排(Ranking):重模型精细打分,输出几十个结果,这是效果的主战场。
- 重排(Re-ranking):业务规则层——去重、多样性打散、冷启动兜底、新鲜度、合规过滤等。
每一阶段都要能说出候选数量级和延迟预算,这是体现系统 sense 的关键。
三、数据与特征
特征分三类:用户特征(画像、历史行为序列、长期/短期兴趣)、物品特征(类目、文本/图像 embedding、统计特征)、上下文特征(时间、地点、设备、当前 session)。. Χ
要点:
- 训练样本构造:曝光点击为正、曝光未点击为负;但要注意样本选择偏差(selection bias)——训练集只来自曝光样本,而线上要对全量候选打分。
- Position bias:排得靠前天然点击率高,可以用随机流量、位置特征或 IPS(inverse propensity scoring)纠偏。
- 特征工程:连续特征分桶/归一化、ID 类特征做 embedding、交叉特征;时序行为序列是推荐里最有信息量的信号之一。
四、模型选择.google и
- 召回:双塔模型(用户塔/物品塔,线上做 ANN 检索)、协同过滤、Item2Vec 等 embedding 方法;优点是快、可扩展。
- 排序:演进路线 LR → GBDT+LR → Wide&Deep → DCN → DIN/DIEN → Transformer。逻辑是:表达能力越来越强,对特征交叉的自动化程度越来越高。选型看场景:数据量小、延迟敏感用 LR/GBDT;行为序列丰富用 DIN/Transformer;需要显式高阶交叉用 DCN。.--
- 记住结论句:没有银弹,模型选型 = 数据规模 × 延迟预算 × 业务目标的 trade-off。
. 1point 3 acres
五、训练与评估
- 离线指标:AUC(排序常用)、GAUC(按用户加权,更贴近线上)、NDCG(TopN 场景)。
- 在线指标:CTR、转化率、停留时长、留存——这才是业务真正关心的北极星。
- 为什么离线涨、在线不涨?常见原因:离线训练/评估与线上分布不一致(样本偏差)、指标与业务目标错位(AUC 涨但时长没涨)、特征穿越或延迟导致线上线下不一致、辛普森悖论(整体涨、分组跌)。
- A/B 实验要点:随机分流、AA 校验、样本量与最小可检测效应(MDE)、实验周期覆盖周末效应、新奇效应(novelty effect)衰减后再看结论。
六、部署与 Serving
- 模型上线:离线训练 → 模型仓库版本管理 → 灰度发布 → 全量。.
- 特征服务:离线特征(T+1 统计特征,走数仓)vs 实时特征(用户最近行为,走流式/特征存储 Feature Store),注意线上线下特征一致性。
- 延迟优化:模型蒸馏/量化/剪枝、召回截断候选数、缓存热门结果、异步更新用户 embedding、粗排减负。
七、监控与迭代
- 数据漂移:特征分布、标签分布监控,设阈值告警。
- 模型衰减:效果随时间自然下降,建立定期重训/增量训练机制。
- Bad case 分析闭环:线上 bad case → 标注/归因(是召回没捞到、排序打分错,还是重排规则误杀)→ 针对性加特征/调样本/改策略 → 离线验证 → A/B 上线。这套闭环讲清楚,面试官会觉得你真做过系统。
八、常考追问
- 冷启动:新用户/新物品没有行为数据怎么办?用画像/内容特征兜底、bandit 探索、降级策略。
- Exploration vs Exploitation:Epsilon-greedy、UCB、Thompson Sampling,推荐里用来给新物品机会。
- 多目标:点击、时长、留存经常打架——加权求和最简单但权重难调;约束优化(主目标优化、次目标设约束);帕累托前沿思路。
- 公平性:不同人群/商家的曝光公平,bias 审计与缓解。
掌握这套框架,ML System Design 轮就不再是玄学:每一轮追问,本质上都是在框架的某一个节点上往深了挖。有问题欢迎留言讨论,一起交流备考心得。
上一篇:DRW QR OA超级新鲜版 10/1 下一篇:《MLE面试ML System Design万能框架:以推荐系统为例,一次讲透》