中级农民
- 积分
- 178
- 大米
- 颗
- 鳄梨
- 个
- 水井
- 尺
- 蓝莓
- 颗
- 萝卜
- 根
- 小米
- 粒
- 学分
- 个
- 注册时间
- 2015-10-6
- 最后登录
- 1970-1-1
|
注册一亩三分地论坛,查看更多干货!
您需要 登录 才可以下载或查看附件。没有帐号?注册账号 
x
下面是纯手工写,+AI Format润色
最近准备面试,想把 FlashAttention 从头捋一下。知道它用了 tiling、减少了显存读写,感觉还不够。往下多问一句:softmax 要对整行归一化,切成小块以后怎么保证结果不变?前向没保存 attention matrix,反向传播又拿什么算?
我觉得把这两个问题推明白,才算摸到它的核心。下面从一笔显存账开始,接着推前向和反向,最后聊一下落到 GPU 上的分工。
普通 attention 的计算是:
S = QKᵀ / √d,P = softmax(S),O = PV
先不考虑 dropout 和 mask。假设 batch size 为 1,32 个 heads,序列长度 8192,head dimension 为 128,Q、K、V 都用 BF16。
Q 的大小是:
1 × 32 × 8192 × 128 × 2 = 64 MiB
K、V 也一样,三份加起来 192 MiB。
但 S 的最后两维是 8192 × 8192,如果同样按 BF16 存储:
1 × 32 × 8192 × 8192 × 2 = 4 GiB
一张中间矩阵就 4 GiB。softmax 后的 P 也是这个尺寸。如果中间结果用 FP32,一张就是 8 GiB。
这些数字是张量的理论存储量,实际峰值还取决于 buffer 复用和 autograd 保存了什么。不过问题已经很明显了:序列变长以后,中间矩阵长得比 Q、K、V 快得多。
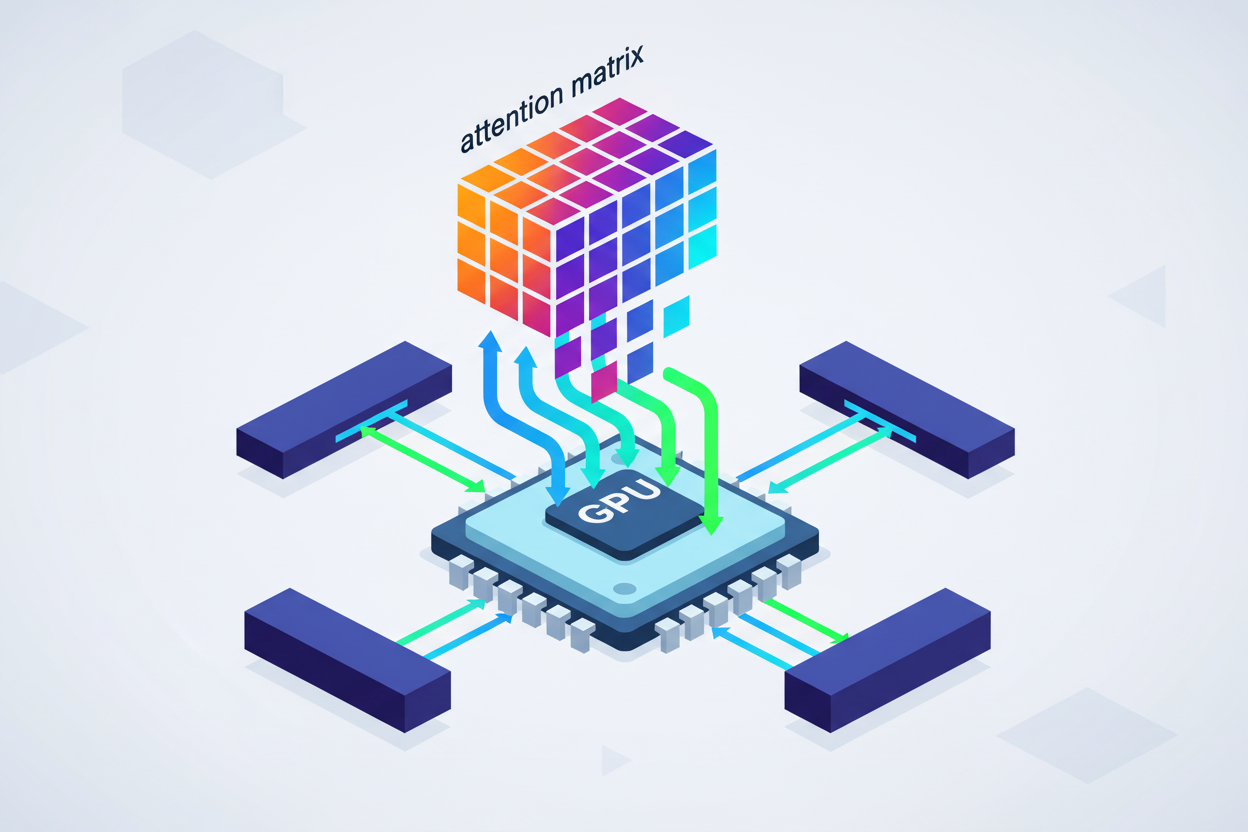
而且这些矩阵还得来回搬。朴素实现先把 S 写到显存,softmax 再读 S、写 P,最后乘 V 时又把 P 读回来。FlashAttention 用分块和融合计算避免完整 S、P 的显存物化,省掉大量读写。原论文
到这里很容易冒出一个想法:那就每块单独算 attention,再把结果合起来?
这个地方可以拿四个数试一下:
- scores = [0, 0 | 10, 10]
- values = [0, 0 | 1, 1]
这里 value 暂时用标量,竖线表示分块。
第一块单独 softmax,再乘 value,结果是 0。第二块算出来是 1。把两块结果平均,得到 0.5。
但完整 attention 的结果是:
2e¹⁰ / (2 + 2e¹⁰) ≈ 0.9999546
第二块应该拿到几乎全部权重。各自做完 softmax 以后,每块的概率和都变成了 1,块与块之间的相对权重就丢了。
所以分块时需要保留一些统计量。
对一行 query,维护:
- m:已经看过的 scores 的最大值。
- ℓ:减去这个最大值后的指数和。
- a:尚未归一化的 value 加权和,是一个向量。
也就是,处理过一部分 key 以后:
ℓ = ∑ⱼ exp(sⱼ − m),a = ∑ⱼ exp(sⱼ − m)vⱼ
最后的输出才是 a / ℓ。
现在来了一块新的 scores s_b 和 values V_b。先更新最大值:
m′ = max(m, max(s_b))
新块可以直接按新基准算:
p_b = exp(s_b − m′)
旧块怎么办?旧的 ℓ 和 a 都是按 m 算的,需要一起换到 m′:
α = exp(m − m′)
ℓ′ = αℓ + ∑ⱼ p_{b,j}
a′ = αa + p_b V_b
更新 m ← m′,继续处理下一块。初始化为 m = −∞,ℓ = 0,a = 0,所有块结束后再做一次 O = a / ℓ。
这几行里,我觉得最值得盯住的是 αa。
只修正分母、忘了修正输出累加器,结果一样会错。因为:
exp(s − m′) = exp(s − m) × exp(m − m′)
旧块的分子和分母必须同时换基准。测试的时候,如果最大 score 恰好一直在第一块,这个错误还可能不暴露,因为后面的 α 都是 1。
理解到这里,再看 Triton 的 fused attention 实现,running max、correction factor 和 accumulator 的更新就能对上了。
接下来是训练时绕不开的 backward。
前向不保存完整 P,但可以给每个 query row 保存一个 logsumexp:
Lᵢ = mᵢ + log ℓᵢ = log(∑ⱼ exp(Sᵢⱼ))
反向需要哪一块概率,就重新计算对应的 scores,再恢复:
Pᵢⱼ = exp(Sᵢⱼ − Lᵢ)
所以 P 可以一块一块重算、一块一块用,不必重新生成整张矩阵存回显存。
还是前面那组尺寸,每行存一个 FP32 的 L,一共只有:
1 × 32 × 8192 × 4 = 1 MiB
当然,这只是在算 L,Q、K、V、O 等反向所需的数据还在。它替代的是保存巨大概率矩阵所需的那部分信息。FlashAttention-2 算法
这里还有个推导挺有意思。softmax 反向里面有一个行内求和,看起来又得把整行概率拿出来,其实可以提前算。
对一个 query row,设输出为 o,上游传来的输出梯度为 g:
o = ∑ⱼ pⱼvⱼ
那么:
∂ℒ/∂pⱼ = g · vⱼ
softmax 反向需要的归约项是:
δ = ∑ⱼ pⱼ(g · vⱼ)
把 g 提出来:
δ = g · (∑ⱼ pⱼvⱼ) = g · o
前向的输出 o 已经有了,上游梯度 g 也有,所以这个量直接做一次点积就能得到。
于是每个 score 的梯度就是:
∂ℒ/∂sⱼ = pⱼ(g · vⱼ − δ)
反向重算一块 P,就能得到这一块的 score 梯度,然后继续累加 Q、K、V 的梯度。往 Q、K 传的时候,还要带上前向的 1/√d。
这样就能理解为什么重计算有时反而更快:多做了一些计算,但避免了巨大中间矩阵的显存读写。这个收益来自具体的访存和计算成本,不能直接套成“重计算总比保存快”。原论文的重计算分析
不过,到这一步只是数学上能分块了,距离一个快的 GPU kernel 还有不少事情。
比如 tile 越大,数据复用通常越充分,但资源占用也跟着涨。假设一个 query tile 有 128 行,head dimension 为 128,仅 FP32 输出累加器的逻辑数据量就有:
128 × 128 × 4 = 64 KiB
此外还有 Q、K、V 的分块、临时 scores 和流水线缓冲。具体哪些放寄存器、哪些放 shared memory,要看实现,不能把这些数字直接全加成 shared-memory 用量。
tile 放大以后,可能出现寄存器 spilling,也可能因为 shared memory 占用太多,导致一个 SM 同时容纳的 CTA,也就是 thread block,变少。少搬几次数据带来的收益,可能被并行度下降抵消。
warp 怎么分工也会影响速度。
以 FlashAttention-2 论文讨论的前向为例,如果不同 warp 负责同一组 query 对不同 K/V 分块的计算,各自得到的是 partial output,最后需要合并。这个过程会引入 shared-memory 读写和同步。
改成不同 warp 负责不同的 query rows,让它们各自计算对应输出,就能减少这部分跨 warp 的合并。这里优化的是数据交换和工作分配,attention 的数学表达式没有变。warp 分工与 block size 讨论
上面的递推也做了一个小规模数值检查:CPU float64 下,覆盖不同序列长度、分块大小和大幅度 scores 的 45 组前向对比,最大绝对误差约 4.44 × 10⁻¹⁶;Q、K、V 的梯度公式用有限差分检查,最大绝对误差约 2.37 × 10⁻¹²。
这验证的是推导,还没覆盖 GPU 低精度、mask/dropout 和实际性能。
如果要继续写 kernel,我会专门测后面的块出现新最大值、长度不能整除 tile 这些情况,再测 causal mask。测训练收益时则要把 forward 和 backward 分开看,最后测完整 step。FlashAttention 仍然保留 dense attention 的平方级计算量;数学上等价,也不意味着不同 BF16 kernel 的输出会逐位一致。PyTorch 数值说明 |
上一篇: 公司claude开始限制token,应该尽力拉爆,还是省着点儿用?下一篇: 用 AI 准备面试的来聊聊?
|




 狗仔卡

 收藏
 淘帖
 好苗
 杂草

 匿名用户-IDM1X
 提升卡
 置顶卡
 关贴卡
 开贴卡
 变色卡
 千斤顶